Agent 持久记忆
虾饺实现了一套三分类持久记忆系统,让 Agent 越用越懂你。
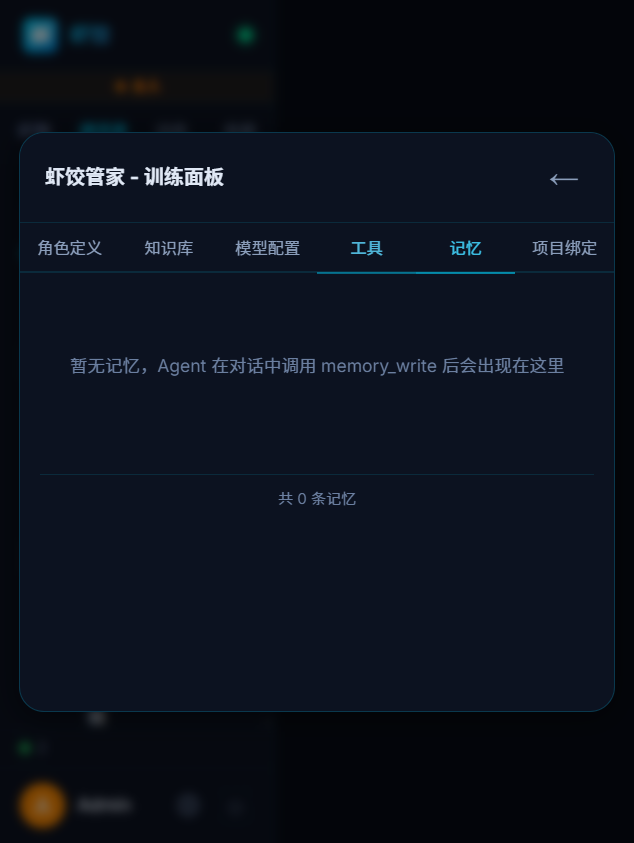
记忆管理面板 — Agent 的记忆条目在此查看和管理
这是虾饺和大多数 AI 聊天工具最大的区别之一:对话不再是"用完即弃"的一次性交互。Agent 能跨对话记住重要信息。写入与检索通过 Tool Calling 中的 memory_write / memory_search 暴露给模型。
为什么需要持久记忆?
普通的 AI 聊天工具每次对话都是从零开始。你告诉过它的偏好、项目背景、约定的规则——下次全忘了。
| 没有记忆 | 有持久记忆 |
|---|---|
| 每次都要重新说明技术栈 | "你用 Python + AWS,我记得" |
| 忘了之前的讨论 | "上次你说想用 Docker 部署" |
| 重复犯同样的错误 | "你说过回复要简洁,不要啰嗦" |
| 所有人一样的回复风格 | 根据你的偏好个性化回复 |
三分类记忆体系
虾饺的记忆系统参考认知科学的长期记忆分类:
1. 语义记忆(Semantic Memory)
存储事实和知识——关于你和项目的客观信息。
| 示例 | 用途 |
|---|---|
| "用户偏好 Python" | 回答技术问题时优先用 Python |
| "公司使用阿里云" | 推荐云服务时考虑阿里云 |
| "项目用 PostgreSQL 数据库" | 写 SQL 时用 PG 语法 |
| "团队采用 Git Flow 分支策略" | 推荐分支操作时遵循 Git Flow |
2. 情景记忆(Episodic Memory)
存储对话事件和经历——发生过什么。
| 示例 | 用途 |
|---|---|
| "上次讨论了 Docker 部署方案" | 延续之前的讨论 |
| "用户提到想做微信接入" | 记住未完成的需求 |
| "上周五一起调试了登录 Bug" | 建立连续的协作体验 |
| "用户对上次的翻译质量不满意" | 改进下次翻译策略 |
3. 程序性记忆(Procedural Memory)
存储行为模式和偏好——你希望 Agent 怎么做。
| 示例 | 用途 |
|---|---|
| "回复要简洁" | 控制输出风格 |
| "代码示例用 TypeScript" | 选择示例语言 |
| "不要用 emoji" | 控制输出格式 |
| "生成代码前先确认需求" | 控制工作流程 |
技术架构
整体流程
┌──────────────────────────────────────────────────────────────┐
│                                                              │
│  写入                                  检索                   │
│                                                              │
│  Agent 对话中                         Agent 新对话开始         │
│     ↓                                    ↓                   │
│  调用 memory_write                    用户消息做 embedding     │
│     ↓                                    ↓                   │
│  文本 → embedding                    余弦相似度搜索记忆库      │
│     ↓                                    ↓                   │
│  相似度去重                           Top-K 结果                │
│  ├── 相似度 > 0.85 → 更新已有记忆       ↓                     │
│  └── 相似度 ≤ 0.85 → 插入新记忆       注入 System Prompt       │
│     ↓                                    ↓                   │
│  存入 SQLite                          Agent 带着记忆回复       │
│                                                              │
└──────────────────────────────────────────────────────────────┘
存储设计
| 组件 | 技术 | 说明 |
|---|---|---|
| 数据库 | SQLite | 每个 Agent 独立数据库文件 |
| 向量存储 | embedding 存入 SQLite | 无需外部向量库 |
| embedding 模型 | 跟随 Agent 配置的 LLM Provider | 默认用 text-embedding-3-small |
| 相似度计算 | 余弦相似度 | JavaScript 原生计算,无依赖 |
| 去重阈值 | 0.85 | 相似度 > 0.85 视为同一条记忆 |
Embedding 去重机制
当 Agent 写入新记忆时,系统自动检查是否已有高度相似的记忆:
新记忆:"用户喜欢 Python"
已有记忆:"用户偏好 Python 语言"
→ 余弦相似度 = 0.95 > 0.85
→ 更新已有记忆,不重复插入

新记忆:"用户今天想了解 Docker"
已有记忆:"用户偏好 Python 语言"
→ 余弦相似度 = 0.3 < 0.85
→ 插入为新记忆
自动注入记忆
当 Agent 配置了 autoInjectMemory: true 时,无需手动操作,每次对话自动触发:
流程:
- 用户发送消息
- 消息文本做 embedding
- 在 Agent 记忆库中余弦相似度搜索
- 取 Top-K 最相关的记忆(默认 10 条)
- 按三分类格式化拼接
- 注入到 System Prompt 的
[MEMORY]区段
注入后的 System Prompt 结构:
# 代码助手

你是一位全栈开发工程师...

## [MEMORY]
以下是你对这位用户的记忆,请参考:

### 语义记忆
- 用户偏好 Python,公司用 AWS
- 项目使用 PostgreSQL 数据库

### 情景记忆
- 上次讨论了 Docker 部署方案,用户希望用 docker-compose

### 程序性记忆
- 回复要简洁,代码示例优先用 Python
性能影响
自动注入通常增加 200-500 个 token 到 System Prompt,对大多数模型来说可以忽略。如果记忆条数很多,系统只取 Top-K 最相关的,不会无限膨胀。
手动使用 memory 工具
即使不开启自动注入,Agent 也可以通过工具手动管理记忆:
memory_write
Agent:[调用 memory_write]
参数:{
  "type": "semantic",
  "content": "用户是后端开发,主要用 Python"
}
memory_search
Agent:[调用 memory_search]
参数:{
  "query": "用户的技术栈"
}
返回:[
  { type: "semantic", content: "用户偏好 Python,公司用 AWS", similarity: 0.87 },
  { type: "semantic", content: "项目使用 PostgreSQL", similarity: 0.72 }
]
记忆隔离
每个 Agent 有独立的记忆空间,互不干扰:
代码助手的记忆:用户偏好 Python、回复要简洁
翻译官的记忆:用户需要中英翻译、偏好信达雅风格
小说家的记忆:用户喜欢唐诗宋词风格、偏好七言律诗
这意味着你可以和不同 Agent 建立不同的"默契"——代码助手知道你的技术偏好,翻译官记住你的翻译口味。
与其他平台记忆系统对比
| 虾饺 | ChatGPT Memory | Claude Projects | |
|---|---|---|---|
| 记忆分类 | 三分类(语义/情景/程序) | 扁平列表 | Project Knowledge |
| 持久化 | ✅ SQLite 本地存储 | ✅ 云端 | ✅ 云端 |
| embedding 去重 | ✅ | ❌ 手动管理 | ❌ |
| 自动注入 | ✅ 可配置 | ✅ | ✅ |
| 多 Agent 隔离 | ✅ 每个 Agent 独立 | ❌ 全局共享 | ❌ 全局共享 |
| 数据私有 | ✅ 本地运行 | ❌ 云端 | ❌ 云端 |
最佳实践
1. 培养 Agent 记忆
前几次对话时主动告诉 Agent 你的偏好:
你:我是一个 Python 后端开发,公司用 AWS,项目用 FastAPI + PostgreSQL。
    回复时优先给 Python 代码,简洁一点,不要啰嗦。
Agent 会主动 memory_write 保存这些偏好。
2. 利用程序性记忆控制行为
你:以后代码示例不要用 var,全部用 const 和 let。
→ 保存为程序性记忆,所有后续代码遵循此规则
3. 定期检查记忆
你:列出你记住的关于我的所有信息
→ Agent 调用 memory_search 展示所有记忆
→ 你可以纠正或补充
4. 在 SOUL.md 中引导记忆行为
在 Agent 的 SOUL.md 里明确告诉它何时记忆:
## 记忆规则
- 用户提到的技术偏好、工作环境 → memory_write(semantic)
- 重要的决定或讨论结论 → memory_write(episodic)
- 用户反复提到的输出偏好 → memory_write(procedural)
- 不记录临时性的闲聊内容
实际对话演示
以下是一个完整的记忆形成和使用过程:
第一次对话(记忆形成):
你:我是 Python 后端开发,在一家金融公司。项目用 FastAPI + PostgreSQL,部署在 AWS。

代码助手:明白!我记住了你的技术栈偏好。

  🧠 正在写入记忆...
  ├── [semantic] 用户是 Python 后端开发,金融行业
  ├── [semantic] 技术栈:FastAPI + PostgreSQL,部署在 AWS
  └── ✅ 已保存 2 条记忆

以后给你写代码会优先使用 Python + FastAPI,数据库操作用 SQLAlchemy...
一周后的对话(记忆生效):
你:帮我写一个用户注册接口

代码助手:
  🧠 检索相关记忆...
  ├── [semantic] 用户是 Python 后端开发,金融行业 (相似度: 0.82)
  ├── [semantic] 技术栈:FastAPI + PostgreSQL (相似度: 0.91)
  └── 注入到上下文

好的,给你一个 FastAPI + SQLAlchemy 的用户注册接口:

(直接给出 FastAPI 代码,不问"你用什么框架")如果没有记忆,Agent 会说"你想用什么框架?Flask 还是 Django 还是 FastAPI?"——多了一轮无意义的确认。
手动查看和管理记忆
通过命令行查看
# 查看某个 Agent 的所有记忆
sqlite3 data/workspace-{agentId}/memory.db \
  "SELECT type, content, created_at FROM memories ORDER BY created_at DESC;"

# 按类型统计
sqlite3 data/workspace-{agentId}/memory.db \
  "SELECT type, COUNT(*) as count FROM memories GROUP BY type;"

# 搜索包含特定关键词的记忆
sqlite3 data/workspace-{agentId}/memory.db \
  "SELECT type, content FROM memories WHERE content LIKE '%Python%';"
删除错误的记忆
# 删除某条不准确的记忆
sqlite3 data/workspace-{agentId}/memory.db \
  "DELETE FROM memories WHERE content LIKE '%过时的信息%';"
导出备份
# 备份记忆数据库
cp data/workspace-{agentId}/memory.db memory-backup-$(date +%Y%m%d).db
相关文档
- Tool Calling —
memory_write/memory_search工具详情与权限配置 - RAG 知识库 — 文档级别的知识检索
- 多 Agent 群聊 — Agent 如何协作
- SOUL.md 写作指南 — 在 SOUL.md 中配置记忆行为
- 模板库 — 20 个可直接复制的 Agent 人格模板
- 安全与隐私 — 数据安全与 API Key 保护
- 实战案例 — 利用记忆实现面试教练、学习助手等